 IA· · 2 min
Efficacité contre Échelle dans l'IA.
Le paysage de l'IA d'aujourd'hui est en effervescence avec des débats sur l'efficacité et des expériences pratiques. De l'amélioration des processus de recrutement à la déchiffration de modèles d'IA complexes, il se passe beaucoup de choses. Plongeons dans les histoires les plus captivantes qui façonnent notre monde technologique.
Efficacité contre Échelle dans l'IA
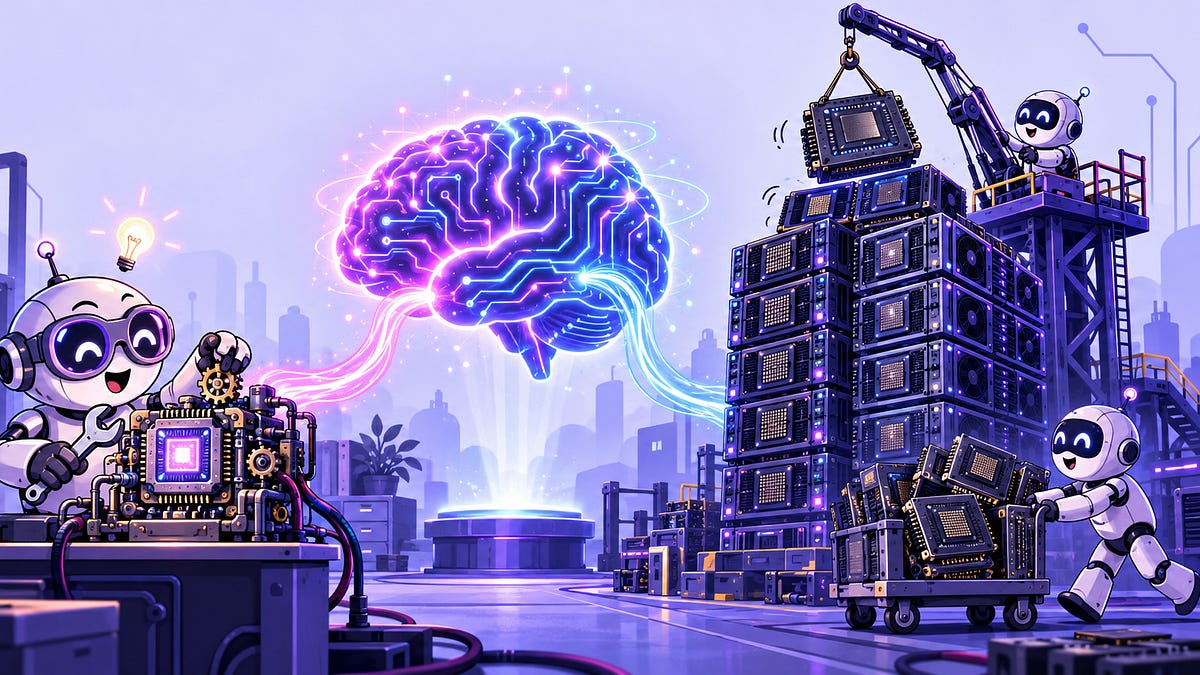
Les laboratoires d'IA chinois et américains empruntent des chemins différents vers le progrès. Les équipes chinoises se concentrent sur l'efficacité algorithmique tandis que les Américains s'appuient sur une infrastructure massive. Le débat ne porte pas seulement sur la vitesse ou la taille ; il s'agit de ce qui donne les meilleurs résultats pour la prochaine génération d'IA.
Expériences pratiques avec l'IA
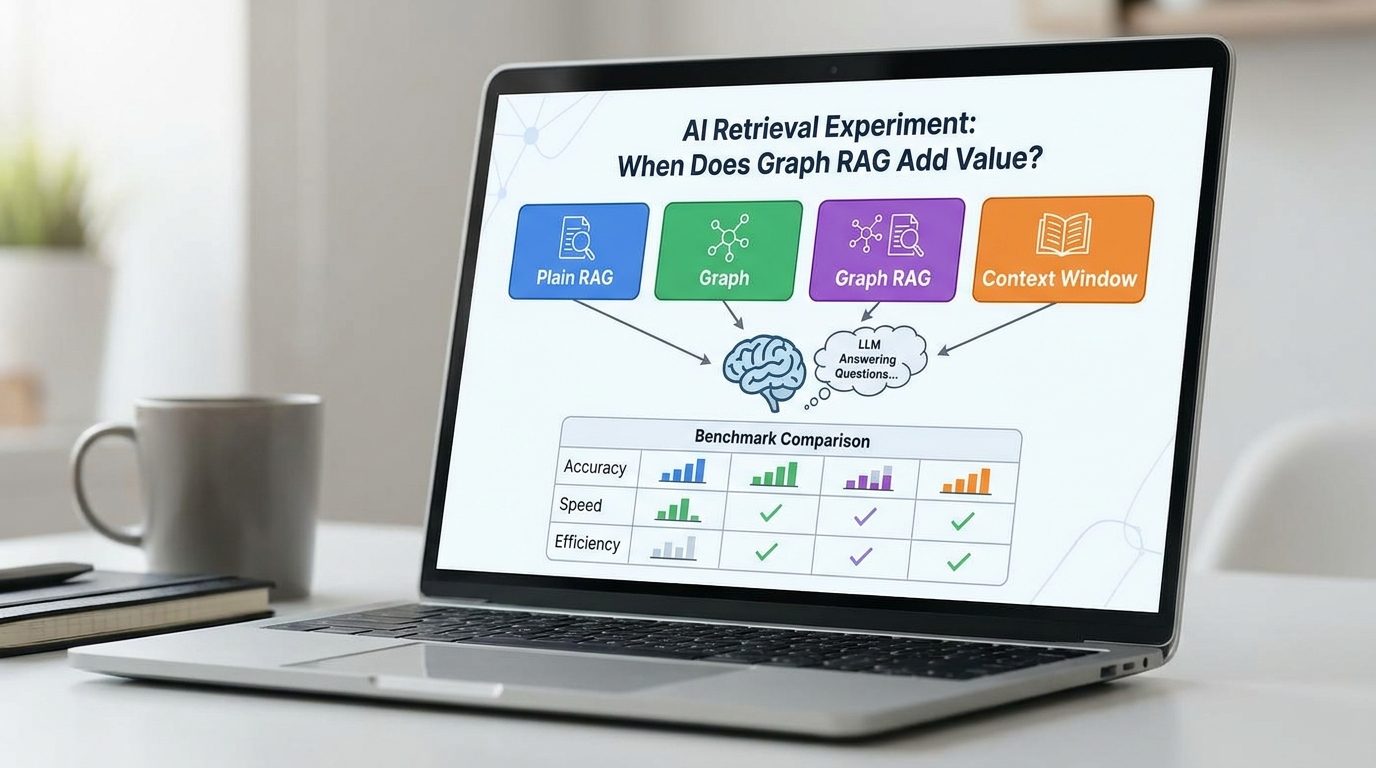
Une expérience récente a exploré la valeur de Graph RAG dans les systèmes de récupération d'IA. Les résultats montrent que bien que les modèles traditionnels fonctionnent bien, l'intégration de graphes de connaissances peut améliorer la compréhension des relations complexes. Cette approche pratique éclaire où investir les efforts d'ingénierie.
L'IA dans le recrutement : Amazon Connect Talent
Amazon rationalise les processus d'embauche avec des solutions alimentées par l'IA qui réduisent le temps d'embauche. En automatisant les évaluations et les entretiens des candidats, ils aident les entreprises à pourvoir des postes plus rapidement et plus efficacement. Cette technologie est un changeur de jeu pour les secteurs confrontés à des défis de recrutement.
Le rôle de l'IA dans la sécurité industrielle
Les données synthétiques améliorent les systèmes d'IA conçus pour la sécurité industrielle. En générant des images d'entraînement réalistes, les entreprises peuvent mieux former les modèles de détection de personnes. Cette innovation répond à des pénuries critiques de données d'entraînement dans des environnements dangereux.
Naviguer dans le désalignement des modèles
OpenAI a introduit un cadre pour signaler le désalignement des modèles. Cela vise à améliorer la transparence et la responsabilité dans les systèmes d'IA. À mesure que l'IA continue d'évoluer, maintenir l'alignement avec les attentes des utilisateurs devient de plus en plus vital.
Réduction de l'utilisation des tokens avec la sortie Markdown de SerpApi pour les requêtes de recherche.
SourceCoût de production initial pour les agents IA dans le secteur financier utilisant le cadre de MRH Trowe.
SourceAmélioration de la précision de détection des personnes utilisant des données synthétiques pour la formation.
SourceEfficacité algorithmique chinoise contre échelle américaine dans l'IA de pointe
Une plongée approfondie sur la façon dont les laboratoires chinois et américains abordent le développement de l'IA. L'un se concentre sur des algorithmes efficaces tandis que l'autre investit massivement dans l'infrastructure. Comprendre ces stratégies est essentiel pour prédire les avancées futures.
OpenAI prétend avoir résolu le problème de Navier-Stokes
OpenAI affirme avoir résolu un problème majeur du Prix du Millénaire, suscitant la controverse dans la communauté mathématique. Cette affirmation pourrait remodeler les perceptions des capacités de l'IA à relever des défis mathématiques complexes.
Amélioration de l'IA de sécurité industrielle avec des données synthétiques
Une approche révolutionnaire pour former l'IA à la sécurité au travail en utilisant des données synthétiques. Cette méthode améliore considérablement les capacités de détection dans des environnements dangereux.
- Building a Data Lakehouse with DuckDB and DuckLakeLearn how to create a cost-effective data lakehouse using DuckDB and DuckLake. — Towards Data Science
- How to Build Effective Evals for AI AgentsA guide to designing effective evaluation systems for AI agents. — KDnuggets
- Silent Broadcasting Can Ruin Your ModelA critical look at how silent broadcasting issues can impact AI model performance. — Towards Data Science
- The KV Cache Tax: Why Inference Servers Run Out of Memory Before ComputeExploring memory management challenges in AI inference servers. — Towards Data Science
- Estimators in Scikit-LLM: A KDnuggets Cheat SheetA handy guide for integrating language models into scikit-learn workflows. — KDnuggets
- 5 Free Zoomcamps From Data Pipelines to AI AgentsExplore free workshops that cover various AI and data engineering topics. — KDnuggets
Cette édition vous a été utile ?
Un clic suffit, ça oriente la prochaine.