 IA· · 2 min
Évolution de l'invite : maîtriser les interactions avec l'IA.
Aujourd'hui, l'IA évolue rapidement, avec de nouveaux outils et techniques redéfinissant notre interaction avec la technologie. De l'optimisation des recherches vectorielles à la fourniture d'un navigateur aux agents LLM, le paysage est en effervescence d'innovation. Plongeons dans les points forts de la semaine.
Évolution de l'invite : maîtriser les interactions avec l'IA

L'ingénierie des invites est de nouveau au centre de l'attention, mais ce n'est plus ce que c'était. À mesure que les LLM deviennent plus intelligents, notre façon de les inviter doit également évoluer. Cette semaine, une plongée approfondie dans des techniques efficaces montre comment engager l'IA de manière efficace pour les tâches de codage.
Agents équipés de navigateurs : un changement de jeu

Imaginez un agent LLM capable de naviguer sur le web, d'interpréter des données et d'agir en conséquence. Cette nouvelle capacité est en cours de construction avec le SDK OpenAI Agents, permettant des interactions plus dynamiques. Les implications pour le support client et les ventes sont énormes.
IA et matériel : un avenir synergique
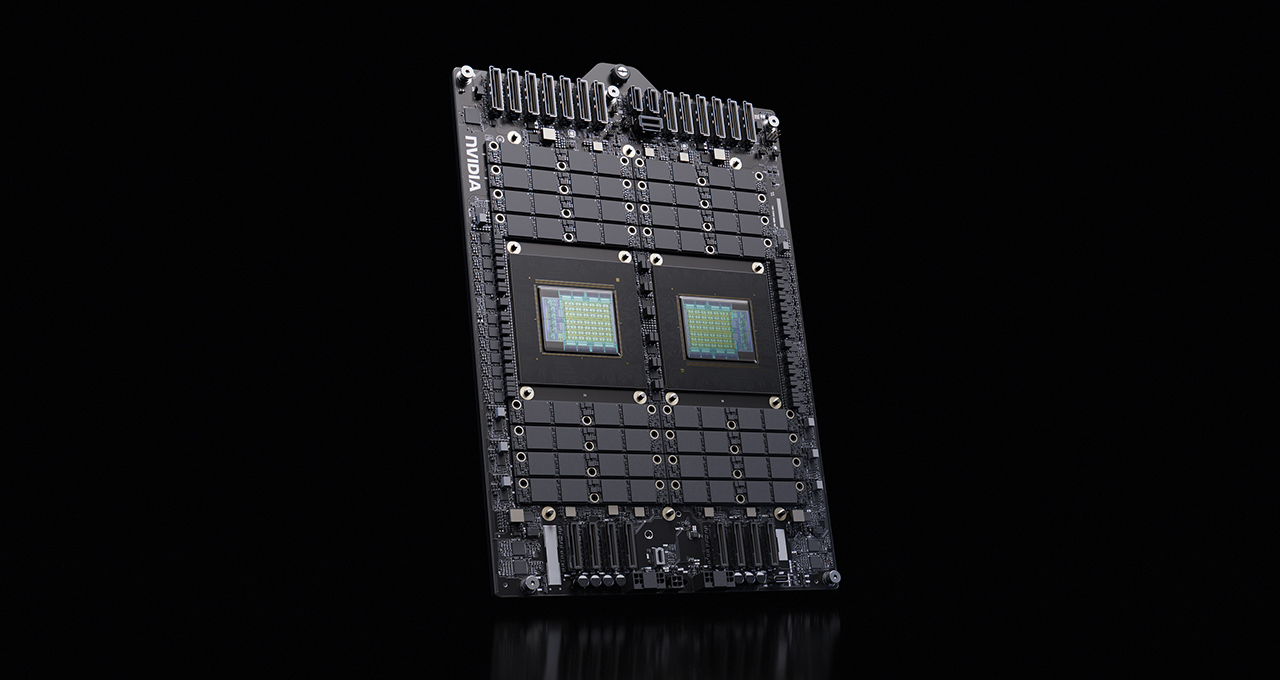
NVIDIA intensifie son jeu avec le CPU Vera, visant à accélérer la conception des processeurs de nouvelle génération. Ce mouvement est crucial pour les demandes croissantes des applications d'IA. Des charges de travail EDA améliorées pourraient signifier des innovations plus rapides dans tous les domaines.
Naviguer sur le marché des relais : un conte d'avertissement
Une nouvelle enquête révèle un marché douteux où les tokens LLM sont revendus à prix réduit. Cela soulève des drapeaux rouges concernant la sécurité et les abus dans les applications d'IA. Les vendeurs doivent renforcer les contrôles pour prévenir l'exploitation.
Optimisation de la recherche vectorielle : coût contre performance

À mesure que les bases de données vectorielles se développent, le coût de la RAM peut exploser. Un accent sur l'optimisation de la recherche vectorielle entre les index sur disque et en mémoire révèle des compromis essentiels pour l'évolutivité. Cela est crucial pour les organisations traitant d'énormes ensembles de données.
Naviguer sur le marché des relais : un conte d'avertissement
Une plongée dans le marché souterrain de la revente de tokens LLM, souvent par des moyens douteux. Cela souligne la nécessité de meilleures mesures de sécurité de la part des vendeurs.
NVIDIA exploite le CPU Vera pour accélérer la conception des CPU et GPU de nouvelle génération
La collaboration de NVIDIA avec Cadence et Synopsys sur le CPU Vera vise à optimiser les processus EDA, ce qui pourrait accélérer le rythme de production de puces pour les applications d'IA.
- How to Efficiently Prompt Claude CodeA guide to effectively prompting AI models for coding tasks to achieve better results. — Towards Data Science
- How to Give an LLM Agent a BrowserBuilding LLM agents that interact directly with browsers could transform support and sales workflows. — Towards Data Science
- How to Optimize Vector Search When RAM Gets Too Expensive: On-Disk vs. In-Memory ANN IndexesAn analysis of the trade-offs between on-disk and in-memory vector search techniques. — Towards Data Science
- The Fluid Simulator That Doesn’t Solve the Fluid EquationsExploring a new approach to fluid simulation that bypasses traditional equations. — Towards Data Science
- KDnuggets Weekly Roundup: Week of July 20, 2026Highlighting key articles and resources in AI from the past week. — KDnuggets
Cette édition vous a été utile ?
Un clic suffit, ça oriente la prochaine.